La donnée biodiversité : un enjeu scientifique et réglementaire majeur
Si le carnet de terrain et le crayon peuvent encore être des alliés des écologues pour certaines campagnes de terrain, la manière dont nous structurons et exploitons les observations naturalistes a profondément évolué.
La donnée biodiversité est au cœur des rapports de diagnostic, des études réglementaires ou encore des plans de gestion. Au-delà du simple pointage géolocalisé, une donnée biodiversité n’a de valeur que si plusieurs paramètres additionnels sont mentionnés : observateur, date, effectifs, etc.
Des outils performants sont donc indispensables pour assurer la fiabilité d’une donnée biodiversité.
1ère problématique : la standardisation des données
Avec le développement constant des technologies, la connaissance sur la biodiversité a explosé. Pour autant, cette masse de données peut à tout moment se perdre dans les méandres d’internet.
Depuis toujours, Teréo a été précurseur dans l’utilisation d’appareils numériques pour l’acquisition des données naturalistes. Les multiples intérêts de ces appareils ont été identifiés très tôt : précision des relevés, confort de travail, simplicité de traitement des données, limitation des erreurs…
Avant l’avènement des smartphones, les appareils utilisés (bien que puissants pour leur époque), nécessitaient un important retravail des données récoltées une fois au bureau pour standardiser nos observations.
Au cours de plus de trois décennies d’activité et d’études de terrain, notre bureau d’études a accumulé un capital historique considérable de plusieurs centaines de milliers d’occurrences taxonomiques. Ce constat nous a conduits à mener une refonte profonde de nos processus informatiques internes pour transformer ce volume d’informations isolées en un véritable socle de connaissance réexploitable.
Pour centraliser nos observations, nous avons fait le choix stratégique d’adopter l’écosystème GéoNature. Développé à l’origine par les parcs nationaux et largement adopté par les acteurs publics de la biodiversité, GéoNature offre un schéma de base de données relationnelle aligné sur les standards du SINP (Système d’Information de l’Inventaire du Patrimoine Naturel). Ce choix garantit la cohérence, la pérennité et l’interopérabilité directe de nos bases internes avec celles des organismes de protection de la nature.
Pour la refonte de ce système, nous avons été accompagnés par un prestataire informatique pour développer :
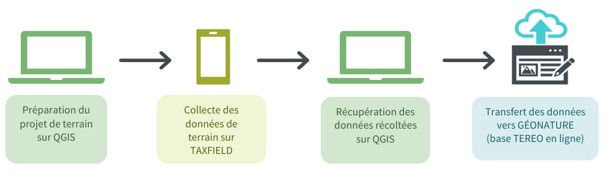
- Une application de saisie de terrain, basée elle-même sur l’architecture QFIELD, et adaptée à nos usages. Elle nous permet d’obtenir un module de saisie rapide des espèces limitant les erreurs. En saisissant le nom de l’espèce que nous observons, celle-ci est directement renseignée avec le référentiel national TAXREF listant les noms scientifiques et français de tous les êtres vivants sur le territoire français. Par ailleurs, l’observation est automatiquement rattachée à un numéro de dossier permettant une traçabilité efficace.
- Deux extensions QGIS pour la préparation de nos sorties terrain et le traitement des données post-terrain :
-
- La première extension nous permet de préparer les couches SIG utilisées dans l’application de terrain pour la saisie de nos observations (module de saisie évoqué ci-dessus). D’autre part, elle permet le traitement de nos observations après terrain en les envoyant automatiquement vers notre base GéoNature en ligne.
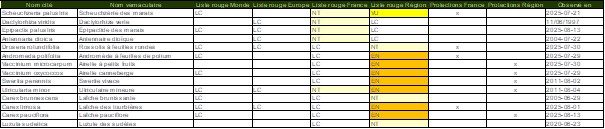
- La seconde extension nous permet de traiter en masse toutes les observations d’une étude (données bibliographiques, données de terrain) et d’en produire des tableaux de synthèse avec les différents statuts des espèces. La grande force de ce module est sa rapidité de traitement (même si plusieurs milliers de données sont exploitées) et sa gestion des doublons.
-
2ème problématique : la compilation de toutes les données liées à la biodiversité
À mon sens, une grande difficulté rencontrée aujourd’hui est la multiplication des plateformes en ligne pour la récupération de données liées à la biodiversité :
- Les données de pointages de taxons sont plutôt gérées à l’échelle régionale avec des bases différentes : BiodivAURA pour la région Auvergne-Rhône-Alpes, Silene pour la région Provence-Alpes-Côte d’Azur, Sigogne en Bourgogne-Franche-Comté, etc.
- Ces bases disposent d’architectures différentes :
-
- BiodivAURA : architecture GéoNature ;
- Silene : architecture hybride GeoNature et architecture développée en interne ;
- Sigogne : architecture développée en interne.
-
- Les données qui renvoient aux sujets IOTA (« loi sur l’eau ») sont traitées par d’autres services de l’État et à des échelles variables. À titre d’exemple :
-
- Les pointages de données invertébrés aquatiques ne sont pas toujours remontés de manière exhaustive dans les plateformes type BiodivAURA. Les données piscicoles disposent d’une obligation de remontée pour toute pêche d’inventaire sur une plateforme nationale ;
- Les connaissances sur les zones humides sont traitées à l’échelle départementale. Elles ne peuvent pas être intégrées à des bases comme BiodivAURA où l’entrée initiale est la donnée taxonomique. Les délimitations des zones humides sont généralement bien compilées par les services départementaux de l’État mais les relevés initiaux tels que les sondages pédologiques ou les relevés floristiques ne sont pas récupérés.
-
Vers une organisation commune des données à l’échelle du territoire national ?
La loi pour la reconquête de la biodiversité du 8 août 2016 a rendu obligatoire le dépôt des données brutes de la biodiversité pour les porteurs de projets.
Cette transmission est rendue possible par la plateforme DEPOBIO, intégrée au Système d’Information de la Nature et des Paysages (SINP). Les données déposées sur DEPOBIO sont ensuite transmises et intégrées aux plateformes régionales. À ce jour, seules les données de taxons peuvent être récoltées.
Au regard de la masse de données produites chaque année à l’échelle du territoire, une centralisation unique de toutes les données liées à la biodiversité semble peut-être complexe. Se pose donc plutôt la question d’homogénéiser la structure des données par l’usage d’un écosystème numérique commun ? Le partage de la donnée sera grandement amélioré et la biodiversité sera ainsi mieux protégée.
Matthieu PUXEDDU